模型安全
Uniguard 大模型安全审查项目
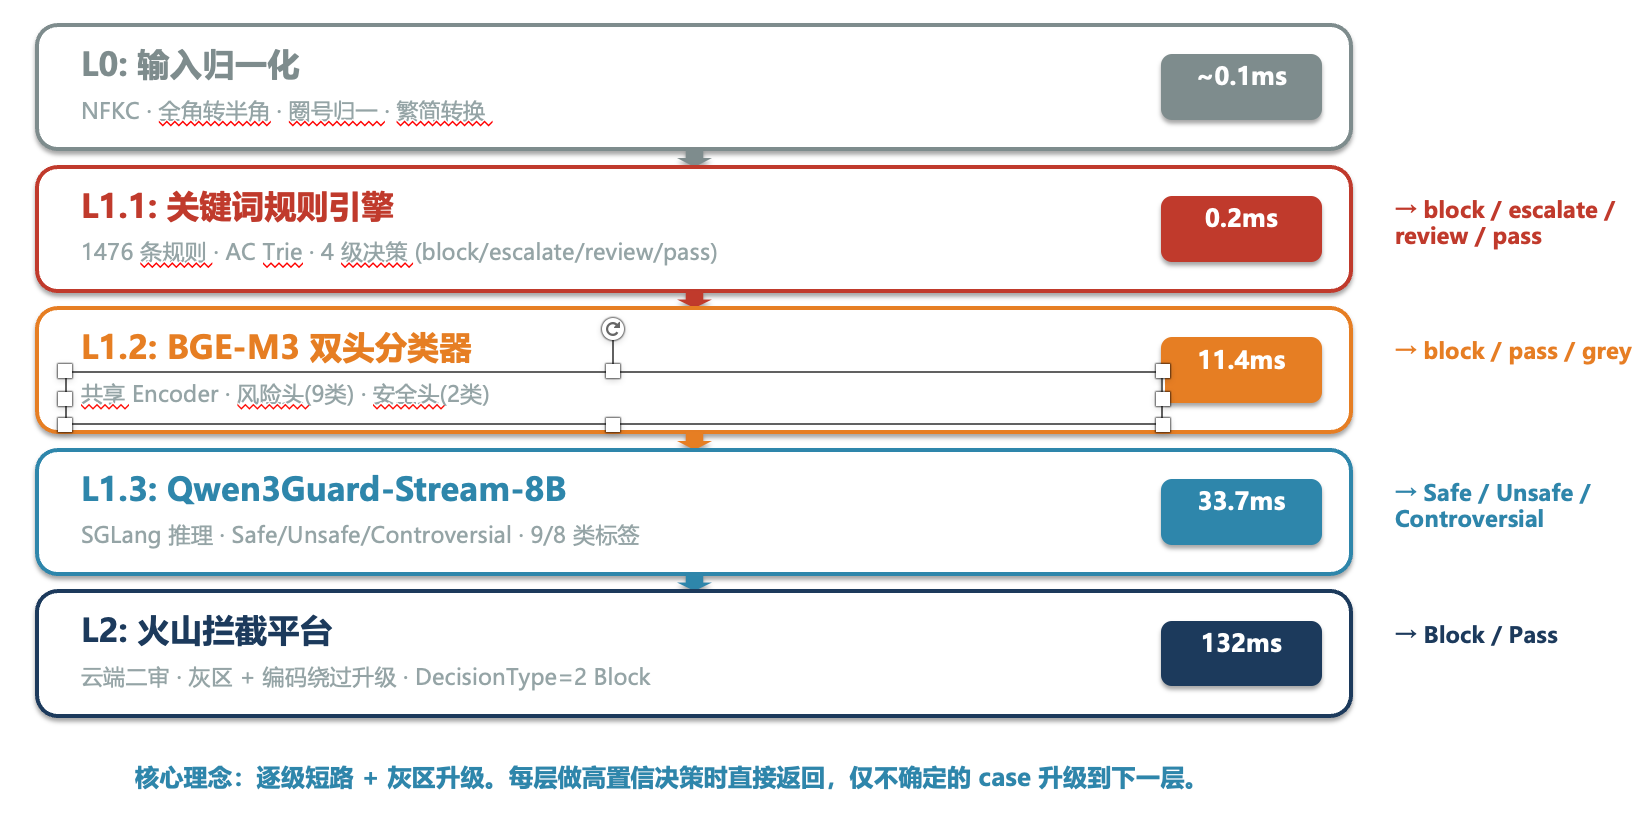
Uniguard 是一套面向大模型内容安全的分层审查流程。项目以降低外部审核成本为目标,通过关键词规则、BGE-M3 双头分类器、Qwen3Guard-Stream-8B 与外部拦截平台逐级完成风险判断。
项目背景
公司的自研大模型为 Unisound 山海大模型,原有安全审查使用火山拦截平台,每次审核费用为 0.010434368。为了降低审核成本,项目组开始自研安全审查流程。
整体流程遵循“逐级短路、灰区升级”的思路:每一层对高置信结果直接返回,仅将不确定样本交给下一层处理。
一、BGE-M3 双头分类器
在冻结 Encoder 的基础上,模型增加了两个分类头:
| 分类头 | 作用 | 输出 |
|---|---|---|
| 风险分类头 | 识别输入内容对应的风险类别 | 与 Qwen3Guard 的风险分类对齐 |
| 安全分类头 | 判断输入内容是否安全 | Safe / Unsafe |
训练数据
| 阶段 | 处理方式 | 数据结果 |
|---|---|---|
| 数据来源 | 钉钉群“文本内容合规日志运营” | 金标数据、可用数据和不可用数据 |
| 初次采样 | 从金标数据和可用数据中采样 | Safe 8,001 条;Unsafe 16,182 条 |
| 多模型审核 | 使用 MiniMax 2.5、Q3 和 Qwen3Guard-Stream;仅保留三个模型均合规或均不合规的数据 | Safe 5,521 条;Unsafe 9,763 条 |
| Wrapped 扩展 | 随机选取 200 条数据增加 Wrapped 样本 | 708data_safe5521_unsafe9763_with200wrapped.json |
测试数据与阈值结果
测试集由 2,000 条人工 Review 的开发集数据构成。两侧阈值分别设置为 0.9999 与 0.99999。
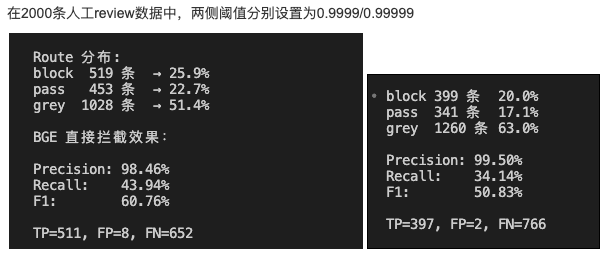
| 阈值 | Block | Pass | Grey | Precision | Recall | F1 |
|---|---|---|---|---|---|---|
| 0.9999 | 519 | 453 | 1,028 | 98.46% | 43.94% | 60.76% |
| 0.99999 | 399 | 341 | 1,260 | 99.50% | 34.14% | 50.83% |
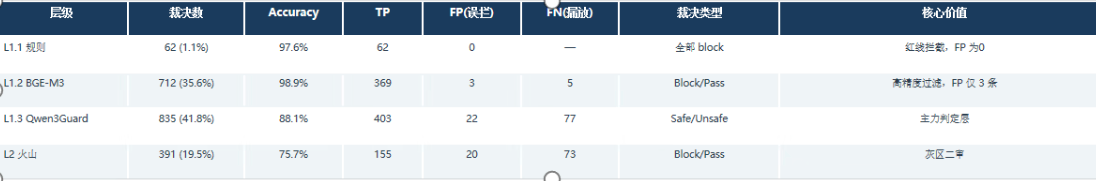
在分层流程中,各层的截流情况如下:
| 层级 | 截流数 | 占比 | Accuracy | TP | FP | FN | 输出类型 |
|---|---|---|---|---|---|---|---|
| L1.1 规则 | 62 | 1.1% | 97.6% | 62 | 0 | — | 全部 Block |
| L1.2 BGE-M3 | 712 | 35.6% | 98.9% | 369 | 3 | 5 | Block / Pass |
| L1.3 Qwen3Guard | 835 | 41.8% | 88.1% | 403 | 22 | 77 | Safe / Unsafe |
| L2 火山 | 391 | 19.5% | 75.7% | 155 | 20 | 73 | Block / Pass |
二、Qwen3Guard-Stream-8B LoRA 微调
原模型评测结果
| 版本 | 评测方式 | Accuracy | TP | FP | FN | TN | Precision | Recall | F1 |
|---|---|---|---|---|---|---|---|---|---|
| 8B 原模型 | SGLang | 85.60% | 961 | 86 | 202 | 751 | 91.79% | 82.63% | 86.97% |
第一次微调
依据 QwenGuard 论文中的方法,将原始数据按 Safe / Unsafe 分层拆分为 A、B 两部分,并分别训练 Strict 与 Loose 模型:
| 数据组 | Safe | Unsafe | 训练模型 |
|---|---|---|---|
| A | 2,760 | 4,881 | A-Strict / A-Loose |
| B | 2,761 | 4,882 | B-Strict / B-Loose |
708data_safe5521.json 与 708data_unsafe9763.json 作为高置信训练数据。A、B 两组的 Strict / Loose 模型交叉预测 716 数据中的 24,183 条 Prompt,并选取 Strict 判定 Unsafe、同时 Loose 判定 Safe 的争议数据。
Strict 模型采用 1:1.6 的训练权重,Loose 模型采用 1.6:1 的训练权重,得到:
| 输出文件 | 数据类型 | 数量 |
|---|---|---|
safe.jsonl | Safe | 7,201 |
unsafe.jsonl | Unsafe | 14,564 |
controversial.jsonl | Controversial | 2,418 |
最终评测结果
| 版本 | 评测方式 | Accuracy | TP | FP | FN | TN | Precision | Recall | F1 |
|---|---|---|---|---|---|---|---|---|---|
| 8B v2 Normal-weight User Prompt LoRA | SGLang Merge Rerun | 80.30% | 1,111 | 342 | 52 | 495 | 76.46% | 95.53% | 84.94% |
第二次微调
对原始的 8,001 条 Safe 数据和 16,182 条 Unsafe 数据,分别使用腾讯、阿里和百度的安全审核服务进行判断。三个服务均会返回 Block、Review 或 Pass 三种结果,汇总如下:
| 原始标签 | 3 合规 | 2 合规 | 其他 | 1 合规 | 0 合规 | 总计 |
|---|---|---|---|---|---|---|
| Safe | 4,992(1) | 1,568(2) | 406(3) | 727(4) | 308(5) | 8,001 |
| Unsafe | 2,215(6) | 3,108(7) | 1,925(8) | 4,641(9) | 4,293(10) | 16,182 |
数据使用情况
| 版本 | Safe | Unsafe | Controversial / Boundary |
|---|---|---|---|
| 728.1 | (1)(2),共 6,560 条 | (9)(10),共 8,934 条 | (7),共 3,108 条 |
| 728.2 | (1)(2),共 6,560 条 | (9)(10),共 8,934 条 | (6),共 2,215 条 |
| 728.3 | (1)(2),共 6,560 条 | (9)(10),共 8,934 条 | (6)(7),共 5,323 条 |
| 729.1 | (1)(2),并对政治、偏见等 Safe hard case 加权 | (9)(10) | (7)作为正常 Boundary;(6)保留,但大幅分层降权 |
| 729.2 | (1)(2) | 将(9)(10)从 8,934 条随机下采样至 6,560 条 | (7)略微降权;(6)分层降权 |
| 730.1 | (1)(2) | (9)(10),共 8,933 条 | 改用四模型从(6)(7)中筛选 Controversial,再随机抽取 2,000 条 |
| 802.1 | (1)(2),另将(6)(7)中 Strict 双模型判定为 Safe 的样本加入 Safe | (9)(10) | (6)(7)中的其余样本作为 Controversial |
| 802.2 | 同 802.1,但从(6)(7)中筛选更少的 Safe,目标为 1,500 条 | (9)(10) | (6)(7)中保留更多样本作为 Controversial |
| 802.3 | (1)(2) | (9)(10) | (7)作为 Controversial;(6)仅保留筛选后的 408 条非政治敏感数据 |
| 802.4 | (1)(2),加上(6)中 1,807 条政治敏感话题数据并改作 Safe | (9)(10) | (7)作为 Controversial;(6)中剩余 408 条作为 Controversial |
最终结果指标
| 版本 | TP | FP | FN | TN | Acc | Precision | Unsafe Recall | F1 | ΔFP | ΔFN |
|---|---|---|---|---|---|---|---|---|---|---|
| 8B 原模型 | 961 | 86 | 202 | 751 | 85.60% | 91.79% | 82.63% | 86.97% | 0 | 0 |
| 722 v2 normal | 1,111 | 342 | 52 | 495 | 80.30% | 76.46% | 95.53% | 84.94% | +256 | −150 |
| 728 boundary-soft | 1,075 | 205 | 88 | 632 | 85.35% | 83.98% | 92.43% | 88.01% | +119 | −114 |
| 728.1 old3108 | 1,067 | 117 | 96 | 720 | 89.35% | 90.12% | 91.75% | 90.92% | +31 | −106 |
| 728 pct2000 user_end | 1,001 | 491 | 162 | 346 | 67.35% | 67.09% | 86.07% | 75.40% | +405 | −40 |
| 728 pct2000 | 1,054 | 138 | 109 | 699 | 87.65% | 88.42% | 90.63% | 89.51% | +52 | −93 |
| 728.2 new2215 | 1,035 | 319 | 128 | 518 | 77.65% | 76.44% | 88.99% | 82.24% | +233 | −74 |
| 728.3 old3108+new2215 | 1,114 | 149 | 49 | 688 | 90.10% | 88.20% | 95.79% | 91.84% | +63 | −153 |
| 729.1 three-api | 1,109 | 144 | 54 | 693 | 90.10% | 88.51% | 95.36% | 91.80% | +58 | −148 |
| 729.1 lr1e4 soft02 | 1,082 | 113 | 81 | 724 | 90.30% | 90.54% | 93.04% | 91.77% | +27 | −121 |
| 729.1 ckpt step400 | 1,094 | 128 | 69 | 709 | 90.15% | 89.53% | 94.07% | 91.74% | +42 | −133 |
| 729.1 ckpt step521 | 1,108 | 149 | 55 | 688 | 89.80% | 88.15% | 95.27% | 91.57% | +63 | −147 |
| 729.2 downsample | 1,067 | 124 | 96 | 713 | 89.00% | 89.59% | 91.75% | 90.65% | +38 | −106 |
| 730.1 | 1,079 | 180 | 84 | 657 | 86.80% | 85.70% | 92.78% | 89.10% | +94 | −118 |
| 802.1 | 1,044 | 104 | 119 | 733 | 88.85% | 90.94% | 89.77% | 90.35% | +18 | −83 |
| 802.2 | 1,072 | 168 | 91 | 669 | 87.05% | 86.45% | 92.18% | 89.22% | +82 | −111 |
| 802.3 | 1,093 | 138 | 70 | 699 | 89.60% | 88.79% | 93.98% | 91.31% | +52 | −132 |
| 802.4 | 1,060 | 124 | 103 | 713 | 88.65% | 89.53% | 91.14% | 90.33% | +38 | −99 |
版本结果对比
| 标签变化 | 8B 原模型 | 729.1 |
|---|---|---|
| Safe → Safe | 751 | 693 |
| Safe → Unsafe | 26 | 118 |
| Safe → Controversial | 60 | 26 |
| Unsafe → Safe | 202 | 54 |
| Unsafe → Unsafe | 756 | 1,073 |
| Unsafe → Controversial | 205 | 36 |
项目总结
Uniguard 将低延迟规则、轻量分类器、大模型审查和外部平台组合成分层流程。高置信样本在前层快速返回,不确定样本继续升级,从而在审核质量、响应速度与调用成本之间取得平衡。